Inspection des données de formation#
Mots clés méthodes de données ; analyse des composantes principales, méthodes de données ; diagrammes en violon, méthodes de données ; apprentissage automatique, méthodes de données ; importance des fonctionnalités
Aperçu#
Avant de former un classificateur d’apprentissage automatique, il peut être utile de comprendre lesquelles de nos couches de caractéristiques sont les plus utiles pour distinguer les classes. Les couches de caractéristiques sur lesquelles les modèles sont formés constituent la base de connaissances de l’algorithme. Nous pouvons explorer cette base de connaissances à l’aide de violin plots spécifiques à la classe, et via une approche de réduction de dimensionnalité appelée analyse en composantes principales. Cette dernière transforme notre grand ensemble de données avec de nombreuses variables en un ensemble de données plus petit avec moins de variables (tout en préservant une grande partie de la variance), ce qui nous permet de visualiser un ensemble de données très complexe d’une manière relativement intuitive et simple.
En explorant nos données de formation, nous pouvons en apprendre davantage sur les classes de couverture terrestre que nous souhaitons cartographier (par exemple, le NDVI est-il un bon moyen de distinguer les zones cultivées et non cultivées ?), décider si nous disposons de suffisamment de données de formation et des bonnes fonctionnalités pour que nos modèles puissent cartographier avec précision les classes (existe-t-il des différences distinctes dans les valeurs des couches de fonctionnalités entre les classes ?), et nous positionner pour améliorer le modèle si les résultats ne sont pas satisfaisants (quels types de fonctionnalités pouvons-nous rejeter qui pourraient perturber le modèle ?).
Description#
En utilisant les données de formation écrites dans le fichier du bloc-notes précédent, 1_Extract_training_data, ce bloc-notes va :
Tracez des tracés en violon spécifiques à la classe pour chacune des couches d’entités dans les données d’entraînement
Tracez l’importance de chaque fonctionnalité après avoir appliqué un modèle aux données.
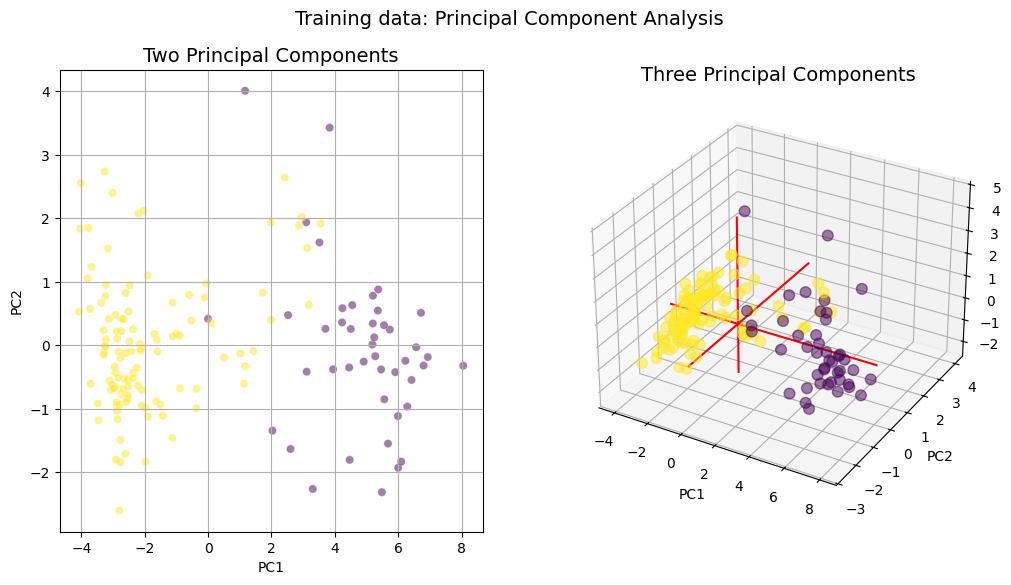
Calculez les deux et trois premiers composants principaux de l’ensemble de données et tracez-les sous forme de diagrammes de dispersion 2D et 3D
Commencer#
Pour exécuter cette analyse, exécutez toutes les cellules du bloc-notes, en commençant par la cellule « Charger les packages ».
Charger des paquets#
[1]:
%matplotlib inline
import os
import random
import numpy as np
import pandas as pd
import seaborn as sns
from pprint import pprint
import matplotlib.pyplot as plt
from matplotlib.patches import Patch
from sklearn.decomposition import PCA
from mpl_toolkits.mplot3d import Axes3D
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
Paramètres d’analyse#
training_data: nom et emplacement du fichier de données d’entraînement.txtgénéré à partir de l’exécution de1_Extract_training_data.ipynbclass_dict: un dictionnaire mappant le nom « chaîne » des classes aux valeurs entières qui représentent nos classes dans les données de formation (par exemple,{'crop' : 1., 'noncrop' : 0.})field: il s’agit du nom de la colonne dans le shapefile de données d’entraînement d’origine qui contient les étiquettes de classe. Ceci est fourni simplement pour que nous puissions supprimer cet attribut avant de tracer les données
[2]:
training_data = "results/test_training_data.txt"

class_dict = {'crop':1, 'noncrop':0}

field = 'class'
Importer des données de formation#
[3]:
# load the data
model_input = np.loadtxt(training_data)

# load the column_names
with open(training_data, 'r') as file:
    header = file.readline()

column_names = header.split()[1:]

# Extract relevant indices from training data
model_col_indices = [column_names.index(var_name) for var_name in column_names[1:]]
Traitement des données#
Cette cellule extrait chaque classe du tableau de données de formation et l’affecte à un dictionnaire. Cette étape permettra de tracer proprement nos données.
[4]:
dfs = {}

# Insert data into a Pandas DataFrame, then split into features and labels
model_input_df = pd.DataFrame(model_input, columns=column_names)
X = model_input_df.drop(field, axis=1)
y = model_input_df[[field]]

# Fit the standard scaler to all features
scaler = StandardScaler(with_mean=False)
scaler.fit(X);

for key, value in class_dict.items():
    print(key, value)
    # extract values for class from training data
    arr = model_input[model_input[:,0]==value]
    # create a pandas df for ease of use later
    df = pd.DataFrame(arr).rename(columns={i:column_names[i] for i in range(0,len(column_names))}).drop(field, axis=1)
    # Scale the dataframe
    scaled_df = scaler.transform(df)
    scaled_df = pd.DataFrame(scaled_df, columns=df.columns)

    dfs.update({key:scaled_df})
crop 1
noncrop 0
Tracés en violon de la couche d’entités#
[5]:
#generate a random list of colors same length as num of classes
get_colors = lambda n: list(map(lambda i: "#" + "%06x" % random.randint(0, 0xFFFFFF),range(n)))
colors = get_colors(len(dfs))

#generate list of offsets & widths for plotting
start=-0.2
end=0.2
offsets = list(np.linspace(start,end,len(dfs)))
if len(dfs) == 2:
    width=0.4
else:
    width=np.abs(offsets[0] - offsets[1])

#create figure and axes
fig, ax = plt.subplots(figsize=(40,8))

for key, color, offset in zip(dfs,colors, offsets):
    #create violin plots
    pp = ax.violinplot(dfs[key].values,
                       showmedians=True,
                       positions=np.arange(dfs[key].values.shape[1])+offset, widths=width
                      )
    # change the colour of the plots
    for pc in pp['bodies']:
        pc.set_facecolor(color)
        pc.set_edgecolor(color)
        pc.set_alpha(1)

    #change the line style in the plots
    for partname in ('cbars','cmins','cmaxes','cmedians'):
        vp = pp[partname]
        vp.set_edgecolor('black')
        vp.set_linewidth(1)

#tidy the plot, add a title and legend
ax.set_xticks(np.arange(len(column_names[1:])))
ax.set_xticklabels(column_names[1:])
ax.set_xlim(-0.5,len(column_names[1:])-.5)
ax.set_ylabel("Scaled Values", fontsize=14)
ax.set_xlabel("Feature Layers", fontsize=14)
ax.set_title("Training Data Knowledge-Base", fontsize=14)
ax.legend([Patch(facecolor=c) for c in colors], [key for key in dfs], loc='upper right');
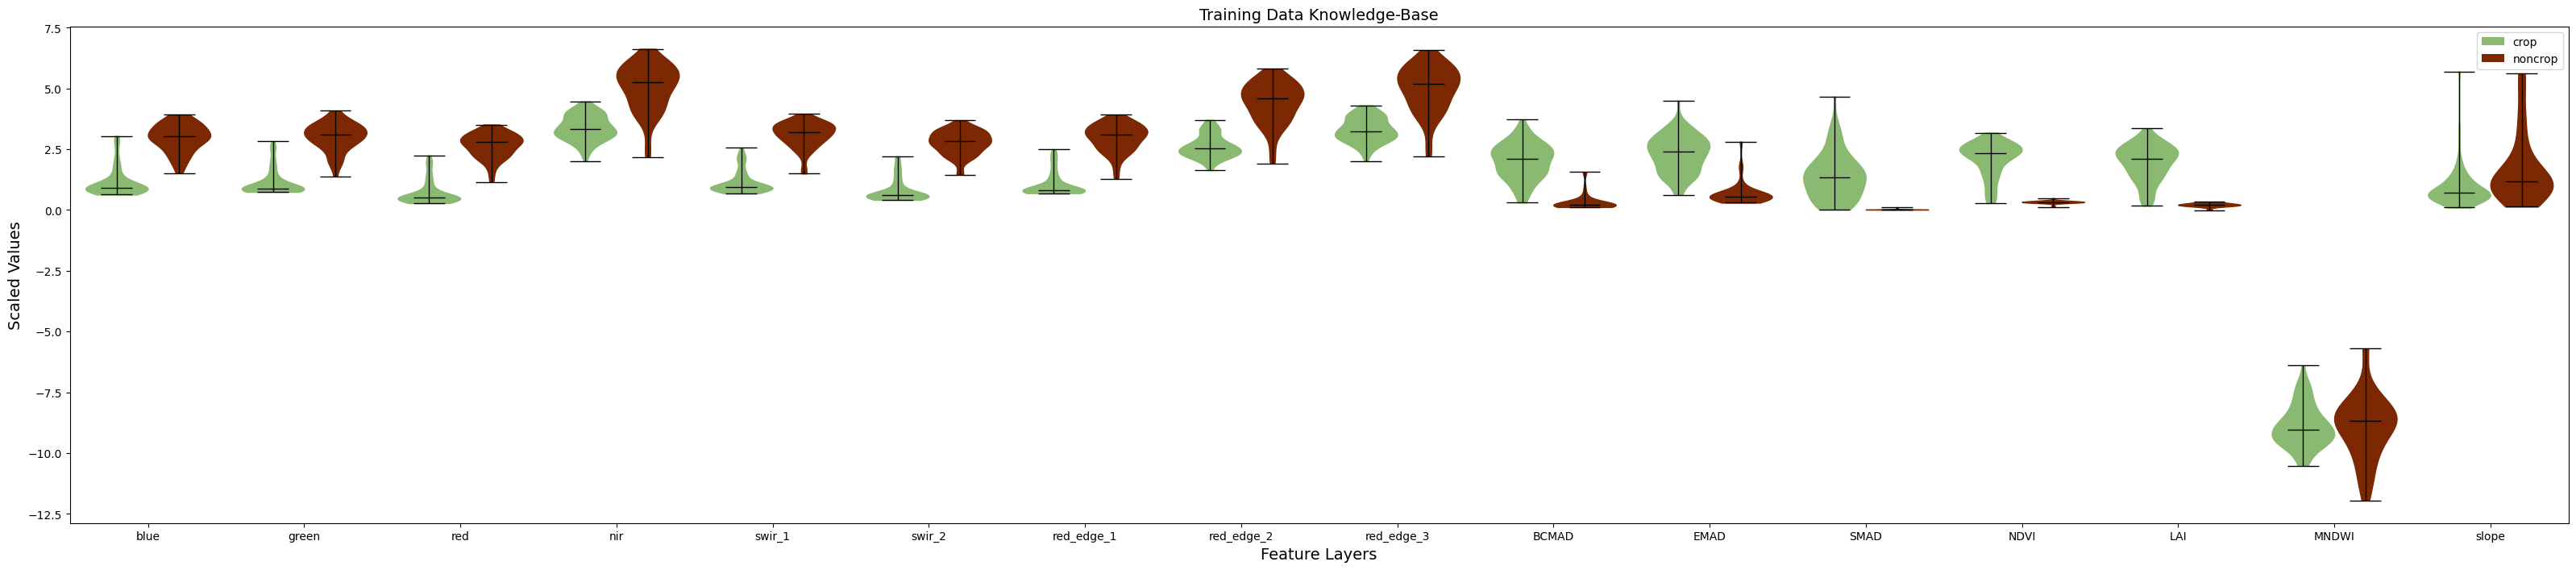
Comme vous pouvez le constater, un certain nombre de nos fonctionnalités présentent une bonne séparation entre les classes de cultures et de non-cultures. Par exemple, les fonctionnalités rouge, verte, bleue, tourbillon, bord rouge 1, NDVI et MNDWI ont toutes des distributions très différentes entre les classes. Cela indique que notre modèle possédera les fonctionnalités appropriées pour faire la distinction entre les cultures et les non-cultures plus tard dans le flux de travail.
Importance des fonctionnalités#
Ici, nous extrayons des estimations du classificateur sur l’importance relative de chaque caractéristique pour l’entraînement du classificateur. Cela est utile pour sélectionner potentiellement un sous-ensemble de bandes/variables d’entrée pour l’entraînement/la classification du modèle (c’est-à-dire pour optimiser l’espace des caractéristiques). Cependant, dans ce cas, nous ne sélectionnons pas un sous-ensemble de caractéristiques, mais essayons simplement de comprendre l’importance de chaque caractéristique. Cela peut nous aider non seulement à mieux comprendre nos classes (par exemple, quels types de mesures sont indicatifs des superficies de terres cultivées), mais peut également conduire à de nouvelles améliorations du modèle.
Sklearn dispose d’une bonne documentation sur différentes méthodes de « sélection de fonctionnalités » <https://scikit-learn.org/stable/modules/feature_selection.html>.
Les résultats seront présentés par ordre croissant, les caractéristiques les plus importantes étant listées en dernier. L’importance est indiquée sous forme de fraction relative comprise entre 0 et 1. Ces importances sont basées sur la mesure dans laquelle une caractéristique donnée, en moyenne, diminue l’impureté de Gini pondérée.
[6]:
model=RandomForestClassifier(random_state=42)
model.fit(X, y.values.ravel());
[7]:
order = np.argsort(model.feature_importances_)

plt.figure(figsize=(15,5))
plt.bar(x=np.array(column_names[1:])[order],
        height=model.feature_importances_[order])
plt.gca().set_ylabel('Importance', labelpad=10)
plt.gca().set_xlabel('Feature', labelpad=10)
plt.tight_layout()
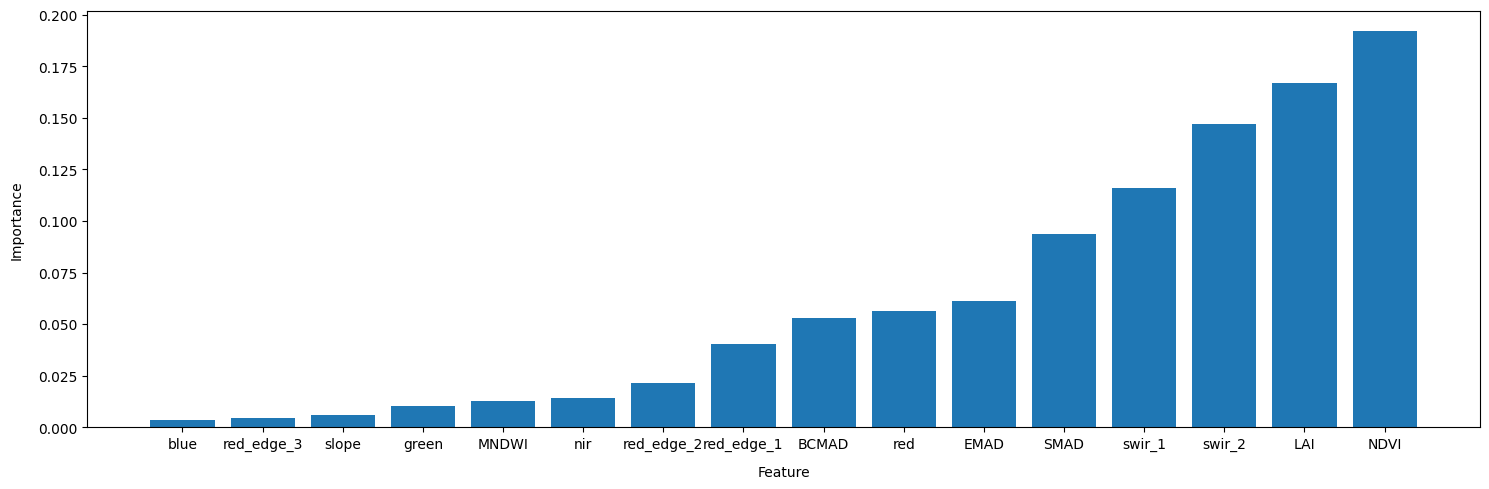
Selon la méthode d’importance des caractéristiques du « RandomForestClassifier » que nous avons adaptée à nos données, les bandes LAI, NDVI et swir_2 sont nos caractéristiques les plus importantes pour distinguer les échantillons de cultures et de non-cultures en Égypte.
Analyse des composantes principales#
Le code ci-dessous calculera et tracera les deux premiers composants principaux de notre ensemble de données d’entraînement. Cela transformera notre ensemble de données avec de nombreuses variables (16 caractéristiques) en un ensemble de données avec moins de variables, ce qui nous permettra de visualiser notre ensemble de données d’une manière relativement intuitive et simple.
La première étape consiste à normaliser nos données pour exprimer chaque couche de caractéristiques en termes de moyenne et d’écart type. Cela est nécessaire car l’analyse en composantes principales est assez sensible aux variances des variables initiales. S’il existe de grandes différences entre les plages des variables initiales, les variables ayant des plages plus grandes domineront celles ayant des plages plus petites (par exemple, une variable comprise entre 0 et 100 dominera une variable comprise entre 0 et 1), ce qui conduira à des résultats biaisés. Ainsi, la transformation des données en échelles comparables peut éviter ce problème. Nous le faisons en utilisant la fonction StandardScalar de sklearn qui normalisera les valeurs d’un tableau à la moyenne et à l’écart type du tableau via la formule :
\begin{align*} z = \frac{x-u}{s} \end{align*}
où \(u\) est la moyenne et \(s\) est l’écart type.
[8]:
# Compute the mean and variance for each feature
X_scaled = scaler.transform(X)
Réaliser les PCA#
[9]:
#two components
pca2 = PCA(n_components=2)
pca2_fit = pca2.fit_transform(X_scaled)
#three PCA components
pca3 = PCA(n_components=3)
pca3_fit = pca3.fit_transform(X_scaled)

#add back to df
pca2_df = pd.DataFrame(data = pca2_fit,
                      columns = ['PC1', 'PC2'])
pca3_df = pd.DataFrame(data = pca3_fit,
                      columns = ['PC1', 'PC2', 'PC3'])

# concat with classes
result2 = pd.concat([pca2_df, pd.DataFrame({'class':model_input[:,0]})], axis=1)
result3 = pd.concat([pca3_df, pd.DataFrame({'class':model_input[:,0]})], axis=1)
Nous pouvons maintenant imprimer la quantité de variance expliquée par les ACP à deux et trois composants.
[10]:
a2,b2 = pca2.explained_variance_ratio_
a3,b3,c3 = pca3.explained_variance_ratio_
print("Variance explained by two principal components = " + str(round((a2+b2)*100, 2))+" %")
print("Variance explained by three principal components = " + str(round((a3+b3+c3)*100, 2))+" %")
Variance explained by two principal components = 83.43 %
Variance explained by three principal components = 89.91 %
Tracer les composantes principales 2 et 3#
[11]:
if len(result2) > 5000:
    result2=result2.sample(n=5000)
if len(result3) > 5000:
    result3=result3.sample(n=5000)

fig = plt.figure(figsize=(12,6))
fig.suptitle('Training data: Principal Component Analysis', fontsize=14)

# First subplot
ax = fig.add_subplot(1, 2, 1)
scatter1=sns.scatterplot(x="PC1", y="PC2",
           data=result2,
           hue='class',
           hue_norm=tuple(np.unique(result2['class'])),
           palette='viridis',
           legend=False,
           alpha=0.5,
           ax=ax
          )

ax.set_title('Two Principal Components', fontsize=14)
ax.grid(True)

# Second subplot
ax = fig.add_subplot(1, 2, 2, projection='3d')
scatter2 = ax.scatter(result3['PC1'], result3['PC2'], result3['PC3'],
                      c=result3['class'], s=60, alpha=0.5)

# make simple, bare axis lines through space:
xAxisLine = ((min(result3['PC1']), max(result3['PC1'])), (0, 0), (0,0))
ax.plot(xAxisLine[0], xAxisLine[1], xAxisLine[2], 'r')
yAxisLine = ((0, 0), (min(result3['PC2']), max(result3['PC2'])), (0,0))
ax.plot(yAxisLine[0], yAxisLine[1], yAxisLine[2], 'r')
zAxisLine = ((0, 0), (0,0), (min(result3['PC3']), max(result3['PC3'])))
ax.plot(zAxisLine[0], zAxisLine[1], zAxisLine[2], 'r')

ax.set_title('Three Principal Components', fontsize=14)
ax.set_xlabel("PC1")
ax.set_ylabel("PC2")
ax.set_zlabel("PC3");
Conclusions#
L’objectif de ce carnet était d’inspecter nos données d’entraînement afin de déterminer leur pertinence pour la classification des zones de terres cultivées. L’excellente séparation entre nos deux ensembles de données, illustrée par les graphiques en violon et en ACP ci-dessus, suggère que nous disposons de suffisamment de données d’entraînement et des bonnes couches de caractéristiques pour procéder à notre problème de classification.
Étapes suivantes recommandées#
Pour continuer à travailler sur les blocs-notes de ce flux de travail « Scalable Machine Learning sur l’ODC », accédez au bloc-notes suivant « 3_Train_fit_evaluate_classifier.ipynb ».
Inspecter_les_données_de_formation (ce bloc-notes)
Informations Complémentaires#
Licence Le code de ce notebook est sous licence Apache, version 2.0 <https://www.apache.org/licenses/LICENSE-2.0>`__.
Les données de Digital Earth Africa sont sous licence Creative Commons Attribution 4.0 <https://creativecommons.org/licenses/by/4.0/>.
Contact Si vous avez besoin d’aide, veuillez poster une question sur le canal Slack DE Africa <https://digitalearthafrica.slack.com/> ou sur le GIS Stack Exchange <https://gis.stackexchange.com/questions/ask?tags=open-data-cube> en utilisant la balise open-data-cube (vous pouvez consulter les questions posées précédemment `ici <https://gis.stackexchange.com/questions/tagged/open-data-
Si vous souhaitez signaler un problème avec ce notebook, vous pouvez en déposer un sur Github.
Version de Datacube compatible
Dernier test :
[12]:
from datetime import datetime
datetime.today().strftime('%Y-%m-%d')
[12]:
'2024-11-05'