Évaluer, optimiser et ajuster un classificateur#
Mots clés méthodes de données ; apprentissage automatique, méthodes de données ; validation croisée, méthodes de données ; hyperparamètres
Aperçu#
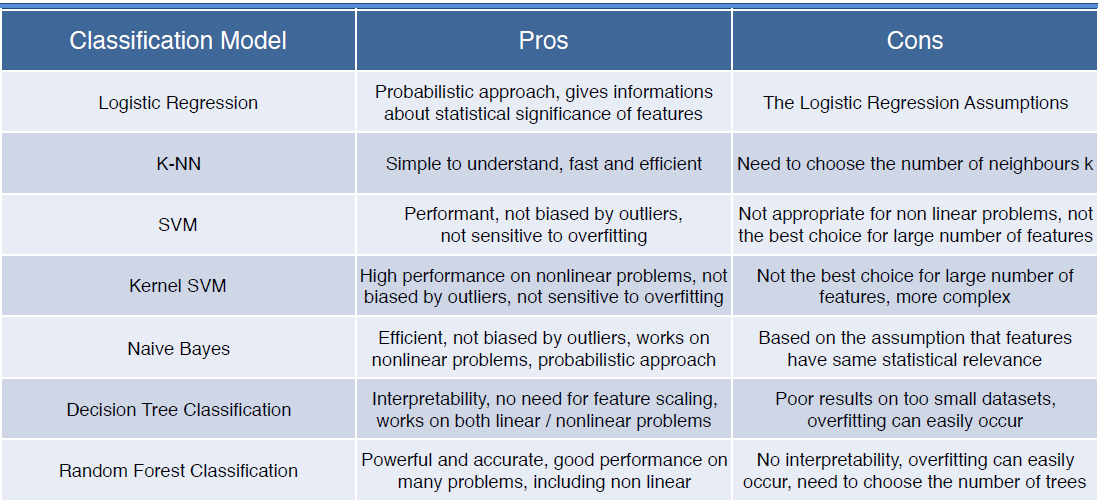
Maintenant que nous avons extrait les données d’apprentissage de l’ODC et que nous les avons inspectées pour nous assurer que les fonctionnalités que nous avons sélectionnées sont appropriées et utiles, nous pouvons entraîner un modèle d’apprentissage automatique. La première étape consiste à décider quel modèle d’apprentissage automatique utiliser. Le choix dépend de la tâche de classification à accomplir. Le tableau ci-dessous fournit un résumé utile des avantages et des inconvénients des différents modèles (tous disponibles via scikit-Learn). Cette aide-mémoire sckit-learn peut également vous aider.
Tableau 1 : certains avantages et inconvénients des différents classificateurs disponibles via scikit-learn
L’approche d’évaluation, d’optimisation et de formation du modèle d’apprentissage automatique supervisé présentée dans ce bloc-notes a été développée pour s’adapter à l’ensemble de données de formation par défaut fourni. L’ensemble de données de formation est petit, contient des données géospatiales et ne contient que deux classes (culture et non-culture).
Étant donné que l’ensemble de données est très petit (
n=156comme indiqué dans le bloc-notes Extracting_training_data), le fait de diviser les données en un ensemble d’entraînement et un ensemble de test, et d’entraîner uniquement le modèle sur l’ensemble d’entraînement le plus petit, dégraderait probablement considérablement la qualité du modèle. Ainsi, nous adapterons le modèle final à toutes les données d’entraînement.Comme nous ajustons le modèle sur toutes les données, nous n’aurons pas d’ensemble de tests restant pour estimer la précision de prédiction du modèle. Nous nous appuyons donc sur une méthode appelée validation croisée imbriquée en k-fold pour estimer la capacité de prédiction de notre modèle. Cette méthode est décrite plus en détail dans le markdown avant le code.
Et comme nous générons une prédiction binaire (culture/non-culture), les mesures utilisées pour évaluer le classificateur sont celles qui conviennent le mieux aux classifications binaires.
Bien que l’approche décrite ci-dessus fonctionne bien pour les données d’entraînement par défaut fournies, elle peut ne pas convenir à votre propre problème de classification. Il est conseillé d’étudier les différentes méthodes d’évaluation et d’entraînement d’un modèle pour déterminer l’approche qui vous convient le mieux.
Description#
Ce bloc-notes décrit l’évaluation, l’optimisation et l’ajustement d’un classificateur d’apprentissage automatique (dans l’exemple par défaut, un modèle Random Forest est utilisé). Sous chacun des sous-titres, vous trouverez plus d’informations sur la manière et la raison d’être de chaque méthode. Les étapes sont les suivantes :
Configurez certains paramètres et importez les données d’entraînement
Calculer une estimation de performance impartiale via une validation croisée imbriquée
Optimiser les hyperparamètres du modèle
Ajuster un modèle à toutes les données d’entraînement en utilisant les meilleurs hyperparamètres identifiés à l’étape précédente
Enregistrez le modèle sur le disque pour l’utiliser dans le bloc-notes suivant, « 4_Classify_satellite_data.ipynb »
Commencer#
Pour exécuter cette analyse, exécutez toutes les cellules du bloc-notes, en commençant par la cellule « Charger les packages ».
Charger des paquets#
[1]:
# -- scikit-learn classifiers, uncomment the one of interest----

# from sklearn.svm import SVC
# from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
# from sklearn.naive_bayes import GaussianNB
# from sklearn.linear_model import LogisticRegression
# from sklearn.neighbors import KNeighborsClassifier

import os
import sys
import joblib
import numpy as np
import pandas as pd
from joblib import dump
import subprocess as sp
import dask.array as da
from pprint import pprint
import matplotlib.pyplot as plt
from odc.io.cgroups import get_cpu_quota
from sklearn.metrics import roc_curve, auc
from sklearn.model_selection import GridSearchCV, ShuffleSplit, KFold
from sklearn.metrics import roc_curve, auc, balanced_accuracy_score, f1_score
Paramètres d’analyse#
training_data: nom et emplacement du fichier de données d’entraînement.txtgénéré à partir de l’exécution de1_Extract_training_data.ipynb« Classifier » : ce paramètre fait référence au modèle de classification scikit-learn à utiliser. Commencez par décommenter le classificateur qui vous intéresse dans la section « Load Packages », puis saisissez le nom de la fonction dans ce paramètre, par exemple : Classifier = SVC.
metric: une chaîne unique qui désigne le scoreur utilisé pour trouver les meilleurs paramètres pour réajuster l’estimateur afin d’évaluer les prédictions sur l’ensemble de tests. Consultez la page des paramètres de notation ici pour une liste prédéfinie d’options. Par exemple,metric='balanced_accuracy'
[2]:
training_data = "results/test_training_data.txt"

Classifier = RandomForestClassifier

metric = 'balanced_accuracy'
Paramètres d’analyse de validation croisée K-Fold#
outer_cv_splits: nombre de divisions de validation croisée à utiliser pour la boucle externe du CV imbriqué. Ces divisions sont utilisées pour estimer la précision du classificateur. Un bon nombre par défaut est de 5 à 10inner_cv_splits: nombre de divisions de validation croisée à utiliser pour la boucle interne du CV imbriqué - les divisions de boucle interne sont utilisées pour optimiser les hyperparamètres. Un bon nombre par défaut est 5.test_size: cela déterminera quelle fraction de l’ensemble de données sera réservée comme ensemble de données de test. Il y a ici un compromis entre avoir un ensemble de test plus grand qui nous aidera à mieux déterminer la qualité de notre classificateur et laisser suffisamment de données pour entraîner le classificateur. Un bon défaut est de réserver 10 à 20 % de votre ensemble de données à des fins de test.
[3]:
inner_cv_splits = 5

outer_cv_splits = 5

test_size = 0.20
Trouver le nombre de CPU#
[4]:
quota = get_cpu_quota()
ncpus = int(quota) if quota is not None else os.cpu_count() or 1
print('ncpus = '+str(ncpus))
ncpus = 4
Importer des données de formation#
[5]:
# load the data
model_input = np.loadtxt(training_data)

# load the column_names
with open(training_data, 'r') as file:
    header = file.readline()

column_names = header.split()[1:]

# Extract relevant indices from training data
model_col_indices = [column_names.index(var_name) for var_name in column_names[1:]]

#convert variable names into sci-kit learn nomenclature
X = model_input[:, model_col_indices]
y = model_input[:, 0]
Calculer une estimation de performance impartiale via une validation croisée imbriquée#
La validation croisée K-fold <https://en.wikipedia.org/wiki/Cross-validation_(statistics)>`__ est une méthode statistique utilisée pour estimer les performances des modèles d’apprentissage automatique lors de la réalisation de prédictions sur des données non utilisées pendant l’entraînement. C’est une méthode populaire car elle est conceptuellement simple et parce qu’elle aboutit généralement à une estimation moins biaisée ou moins optimiste de la compétence du modèle que d’autres méthodes, comme une simple séparation entre l’entraînement et le test.
Cette procédure peut être utilisée à la fois pour optimiser les hyperparamètres d’un modèle sur un ensemble de données et pour comparer et sélectionner un modèle pour l’ensemble de données. Cependant, lorsque la même procédure de validation croisée et le même ensemble de données sont utilisés pour ajuster et sélectionner un modèle, il est probable que cela conduise à une évaluation optimiste des performances du modèle.
Une approche pour surmonter ce biais consiste à imbriquer la procédure d’optimisation des hyperparamètres dans la procédure de sélection du modèle. C’est ce qu’on appelle la validation croisée imbriquée. L’article ici fournit plus de contexte à ce problème. L’image ci-dessous illustre le fonctionnement de la validation croisée imbriquée.
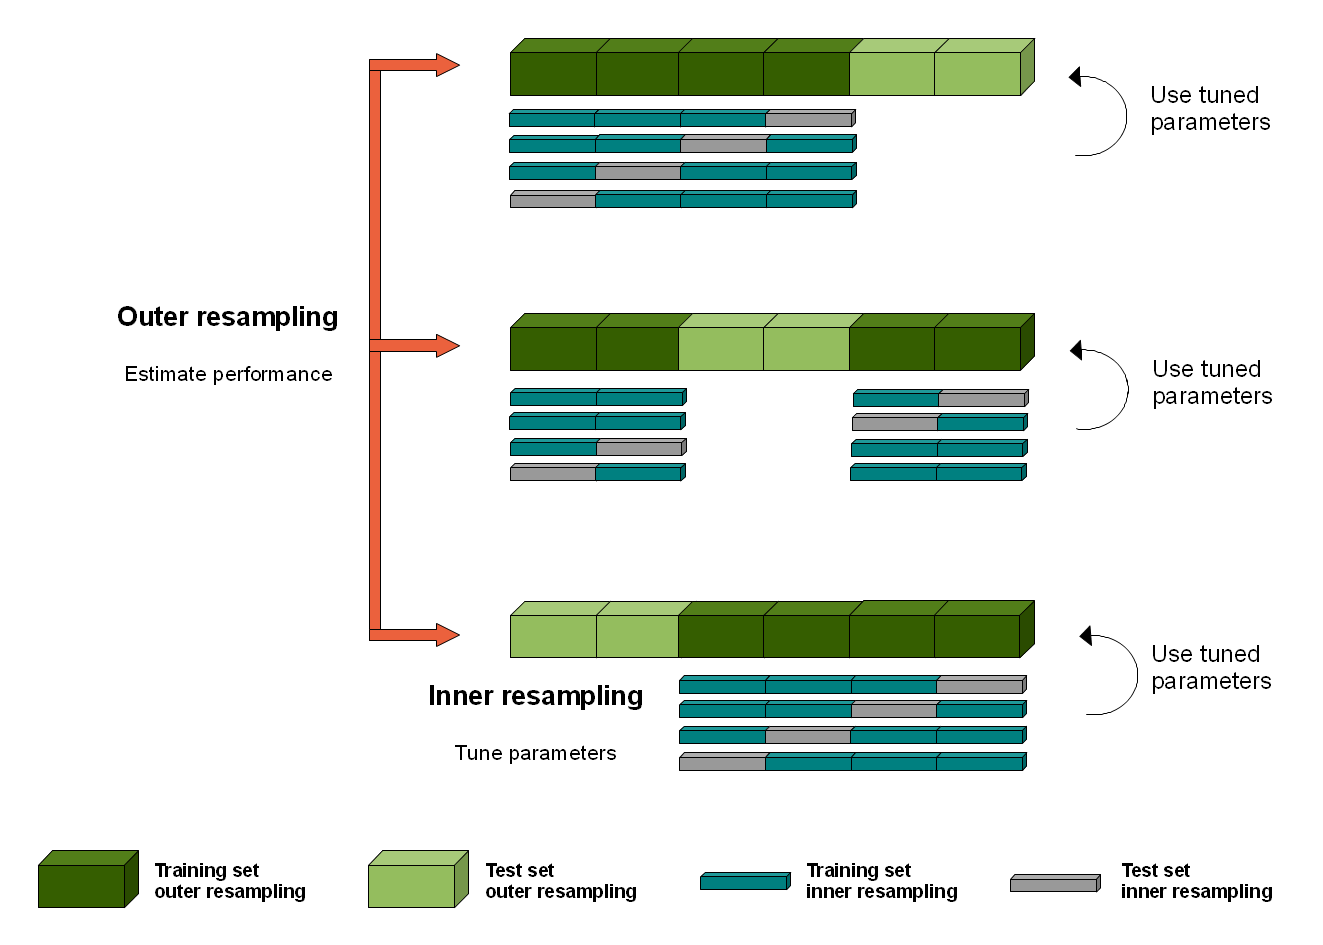
Le résultat de notre validation croisée imbriquée sera un ensemble de scores de précision qui montreront dans quelle mesure notre classificateur est capable de reconnaître des points de données invisibles. L’exemple par défaut est configuré pour afficher les scores « balanced_accuracy » et « f1 » le long de la « courbe de fonctionnement du récepteur, aire sous la courbe (ROC-AUC) ». Cette dernière mesure est une mesure robuste de la capacité de prédiction d’un classificateur. Cet article <https://towardsdatascience.com/understanding-auc-roc-curve-68b2303cc9c5> contient une bonne explication sur ROC-AUC, qui est une mesure courante de l’apprentissage automatique.
Toutes les mesures renvoient une valeur comprise entre 0 et 1, une valeur de 1 indiquant un score parfait.
Pour réaliser la validation croisée imbriquée, nous devons d’abord définir une grille de paramètres à utiliser dans l’optimisation :
« param_grid » : un dictionnaire de paramètres spécifiques au modèle à parcourir lors de l’optimisation des hyperparamètres.
Remarque : les paramètres de l’objet « param_grid » dépendent du classificateur utilisé. L’exemple par défaut est configuré pour un classificateur Random Forest. Pour ajuster les paramètres afin de les adapter à un classificateur différent, recherchez les paramètres importants dans la documentation sklearn appropriée <https://scikit-learn.org/stable/supervised_learning.html>`__.
[6]:
# Create the parameter grid based on the results of random search
param_grid = {
    'class_weight': ['balanced', None],
    'max_features': ["sqrt", "log2", None],
    'n_estimators': [200,300,400],
    'criterion':['gini', 'entropy']
}
[7]:
outer_cv = KFold(n_splits=outer_cv_splits, shuffle=True,
                        random_state=0)

# lists to store results of CV testing
acc = []
f1 = []
roc_auc = []
i = 1
for train_index, test_index in outer_cv.split(X, y):
    print(f"Working on {i}/5 outer cv split", end='\r')
    model = Classifier(random_state=1)

    # index training, testing, and coordinate data
    X_tr, X_tt = X[train_index, :], X[test_index, :]
    y_tr, y_tt = y[train_index], y[test_index]

    # inner split on data within outer split
    inner_cv = KFold(n_splits=inner_cv_splits,
                     shuffle=True,
                     random_state=0)

    clf = GridSearchCV(
        estimator=model,
        param_grid=param_grid,
        scoring=metric,
        n_jobs=ncpus,
        refit=True,
        cv=inner_cv.split(X_tr, y_tr),
    )

    clf.fit(X_tr, y_tr)
    # predict using the best model
    best_model = clf.best_estimator_
    pred = best_model.predict(X_tt)

    # evaluate model w/ multiple metrics
    # ROC AUC
    probs = best_model.predict_proba(X_tt)
    probs = probs[:, 1]
    fpr, tpr, thresholds = roc_curve(y_tt, probs)
    auc_ = auc(fpr, tpr)
    roc_auc.append(auc_)
    # Overall accuracy
    ac = balanced_accuracy_score(y_tt, pred)
    acc.append(ac)
    # F1 scores
    f1_ = f1_score(y_tt, pred)
    f1.append(f1_)
    i += 1
Working on 5/5 outer cv split
Imprimez les résultats de notre évaluation de modèle#
[8]:
print("=== Nested K-Fold Cross-Validation Scores ===")
print("Mean balanced accuracy: "+ str(round(np.mean(acc), 2)))
print("Std balanced accuracy: "+ str(round(np.std(acc), 2)))
print('\n')
print("Mean F1: "+ str(round(np.mean(f1), 2)))
print("Std F1: "+ str(round(np.std(f1), 2)))
print('\n')
print("Mean roc_auc: "+ str(round(np.mean(roc_auc), 3)))
print("Std roc_auc: "+ str(round(np.std(roc_auc), 2)))
print('=============================================')
=== Nested K-Fold Cross-Validation Scores ===
Mean balanced accuracy: 0.93
Std balanced accuracy: 0.03


Mean F1: 0.96
Std F1: 0.01


Mean roc_auc: 0.995
Std roc_auc: 0.01
=============================================
Ces scores représentent une estimation fiable de la précision de notre classificateur. Cependant, étant donné que nous n’utilisons qu’un sous-ensemble de données pour ajuster et optimiser les modèles et que la quantité totale de données d’apprentissage dont nous disposons est faible (seulement 156 échantillons dans l’exemple par défaut), il est raisonnable de penser que ces scores sont une sous-estimation de la précision du modèle final.
De plus, la précision de la carte sera probablement différente de celle indiquée ici, car les données d’entraînement ne sont souvent pas une représentation parfaite des données du monde réel. Par exemple, nous avons peut-être volontairement suréchantillonné des régions difficiles à classer, ou les proportions de classes dans notre ensemble de données peuvent ne pas correspondre aux proportions du monde réel.
Optimiser les hyperparamètres#
Les modèles d’apprentissage automatique nécessitent certains « hyperparamètres » : des paramètres de modèle qui peuvent être ajustés pour augmenter la capacité de prédiction d’un modèle. Trouver les meilleures valeurs pour ces paramètres est une « recherche d’hyperparamètres » ou une « optimisation d’hyperparamètres ».
Pour optimiser les paramètres de notre modèle, nous utilisons GridSearchCV pour rechercher de manière exhaustive un ensemble de paramètres et déterminer la combinaison qui donnera la plus grande précision en fonction de la métrique de précision définie.
Nous rechercherons le même ensemble de paramètres que nous avons défini précédemment, « param_grid ».
[9]:
#generate n_splits of train-test_split
rs = ShuffleSplit(n_splits=outer_cv_splits, test_size=test_size, random_state=0)
[10]:
#instatiate a gridsearchCV
clf = GridSearchCV(Classifier(),
                   param_grid,
                   scoring=metric,
                   verbose=1,
                   cv=rs.split(X, y),
                   n_jobs=ncpus)

clf.fit(X, y)

print('\n')
print("The most accurate combination of tested parameters is: ")
pprint(clf.best_params_)
print('\n')
print("The "+metric+" score using these parameters is: ")
print(round(clf.best_score_, 2))
Fitting 5 folds for each of 36 candidates, totalling 180 fits


The most accurate combination of tested parameters is:
{'class_weight': None,
 'criterion': 'entropy',
 'max_features': 'sqrt',
 'n_estimators': 200}


The balanced_accuracy score using these parameters is:
0.94
Adapter un modèle#
En utilisant les meilleurs paramètres de notre recherche d’optimisation d’hyperparamètres, nous ajustons maintenant notre modèle sur toutes les données.
[11]:
#create a new model
new_model = Classifier(**clf.best_params_, random_state=1, n_jobs=ncpus)
new_model.fit(X, y)
[11]:
RandomForestClassifier(criterion='entropy', n_estimators=200, n_jobs=4,
                       random_state=1)
In a Jupyter environment, please rerun this cell to show the HTML representation or trust the notebook. On GitHub, the HTML representation is unable to render, please try loading this page with nbviewer.org.
Parameters
Sauvegarder le modèle#
L’exécution de cette cellule exportera le classificateur sous forme de fichier binaire .joblib. Cela permettra d’importer le modèle dans le script suivant, 4_Classify_satellite_data.ipynb
[12]:
dump(new_model, 'results/ml_model.joblib')
[12]:
['results/ml_model.joblib']
Étapes suivantes recommandées#
Pour continuer à travailler sur les blocs-notes de ce flux de travail « Scalable Machine Learning sur l’ODC », accédez au bloc-notes suivant « 4_Classify_satellite_data.ipynb.ipynb ».
Evaluate_optimize_fit_classifier (ce notebook)
Filtrage basé sur les objets(facultatif)
Informations Complémentaires#
Licence Le code de ce notebook est sous licence Apache, version 2.0 <https://www.apache.org/licenses/LICENSE-2.0>`__.
Les données de Digital Earth Africa sont sous licence Creative Commons Attribution 4.0 <https://creativecommons.org/licenses/by/4.0/>.
Contact Si vous avez besoin d’aide, veuillez poster une question sur le canal Slack DE Africa <https://digitalearthafrica.slack.com/> ou sur le GIS Stack Exchange <https://gis.stackexchange.com/questions/ask?tags=open-data-cube> en utilisant la balise open-data-cube (vous pouvez consulter les questions posées précédemment `ici <https://gis.stackexchange.com/questions/tagged/open-data-
Si vous souhaitez signaler un problème avec ce notebook, vous pouvez en déposer un sur Github.
Version de Datacube compatible
Dernier test :
[13]:
from datetime import datetime
datetime.today().strftime('%Y-%m-%d')
[13]:
'2026-04-30'