Besoins en eau des cultures irriguées#
Mots-clés données utilisées ; wapor, données utilisées ; masque de culture
Aperçu#
Les besoins en eau des cultures irriguées peuvent être estimés à l’aide d’une gamme de données spatiales liées à l’évapotranspiration réelle, potentielle et de référence. L’estimation peut aider à optimiser le volume et le calendrier des irrigations et à garantir que les ressources en eau sont gérées de manière appropriée. Cela peut améliorer l’efficacité globale de l’utilisation de l’eau et soutenir une utilisation efficace des ressources en eau basée sur les données.
Ce carnet rassemble quelques concepts clés :
L’évapotranspiration (ET) est le processus par lequel l’eau se déplace du sol vers l’atmosphère par évaporation du sol et transpiration par les feuilles des plantes. L’évapotranspiration réelle (ETact) est le taux d’ET observé ou, dans le cas de l’observation de la Terre, estimé.
L’évapotranspiration de référence (ETref) est l’ET d’une culture de référence de gazon court, hypothétique et bien irriguée, poussant dans des conditions idéales, représentant la demande climatique en eau en fonction des conditions météorologiques dominantes.
L’évapotranspiration des cultures (ETc) est l’évapotranspiration de référence appliquée à un type de culture et à un stade de croissance spécifiques, représentant l’ET maximale d’une culture donnée dans des conditions météorologiques données. L’ETc est obtenue en multipliant l’ETref par un coefficient de culture (Kc).
Ces concepts seront explorés plus en détail dans ce carnet. Ils sont également décrits dans divers documents produits par l’Organisation pour l’alimentation et l’agriculture (FAO), notamment l” introduction à l’ET.
Description#
Ce carnet montre comment l’évapotranspiration réelle et de référence peut être utilisée pour identifier l’adéquation de l’irrigation précédente pour une zone donnée et calculer le déficit en eau, le cas échéant.
Premièrement, la zone de terres cultivées est identifiée à l’aide de la carte d’étendue des terres cultivées.
Deuxièmement, l’utilisation réelle de l’eau pour 2024 est estimée.
Enfin, le déficit en eau est cartographié et calculé pour éclairer les besoins d’irrigation pour les saisons futures.
Commencer#
Pour exécuter cette analyse, exécutez toutes les cellules du bloc-notes, en commençant par la cellule « Charger les packages ».
Charger des paquets#
Importez les packages Python utilisés pour l’analyse.
Utilisez les commandes d’importation standards ; certaines sont présentées ci-dessous. Commencez par les commandes magiques iPython, suivies des packages Python standards, puis de toutes les fonctionnalités supplémentaires dont vous avez besoin du package Tools.
[1]:
%matplotlib inline

import datacube
import matplotlib.dates as mdates
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import rioxarray
import xarray as xr
import geopandas as gpd

from datacube.utils.masking import mask_invalid_data
from deafrica_tools.areaofinterest import define_area
from deafrica_tools.plotting import display_map
from deafrica_tools.load_wapor import get_all_WaPORv3_mapsets, get_WaPORv3_info, load_wapor_ds
from odc.geo.geom import Geometry
from odc.geo.xr import xr_reproject
from wapordl import wapor_map, wapor_ts
INFO: WaPORDL (`1.2.1`)
Se connecter au datacube#
Connectez-vous au datacube pour que nous puissions accéder aux données de DE Africa. Le paramètre « app » est un nom unique pour l’analyse qui est basé sur le nom du fichier du notebook.
[2]:
dc = datacube.Datacube(app='Irrigation_water')
Paramètres d’analyse#
La cellule ci-dessous spécifie le dossier dans lequel les données téléchargées seront stockées. Si vous utilisez ce script de manière répétée, il est recommandé de vider ce dossier de temps en temps pour réduire l’espace de stockage sur le volume de la Sandbox.
Veuillez noter que toutes les données de ce dossier seront perdues lorsque vous vous déconnecterez de l’environnement Sandbox. Bonne pratique : téléchargez ou déplacez tous les fichiers importants vers un stockage externe (par exemple, Google Drive ou votre machine locale) avant de vous déconnecter pour éviter de perdre votre travail, comme décrit sur la page d’accueil.
[3]:
folder = "../Supplementary_data/WaPOR" # folder that the data will be sent to
Ensuite, la zone d’intérêt est définie. Il peut également s’agir d’un fichier .geojson que la fonction de chargement accepte. Sinon, deux méthodes sont disponibles :
En spécifiant la latitude, la longitude et la zone tampon (buffer). Cette méthode nécessite de saisir la latitude centrale, la longitude centrale et la valeur du buffer en degrés carrés autour du point central que vous souhaitez analyser. Par exemple,
lat = 30.75,lon = 31.35etbuffer = 0.1sélectionneront une zone d’un rayon de 0,1 degré carré autour du point de coordonnées (30.75, 31.35).Alternativement, vous pouvez fournir des valeurs de buffer distinctes pour la latitude et la longitude afin d’obtenir une zone rectangulaire. Par exemple,
lat = 30.75,lon = 31.35,lat_buffer = 0.1etlon_buffer = 0.08sélectionneront une zone rectangulaire s’étendant de 0,1 degré au nord et au sud, et de 0,08 degré à l’est et à l’ouest à partir du point(30.75, 31.35).Pour des temps de chargement raisonnables, définissez la mémoire tampon sur « 0,1 » ou moins.
By uploading a polygon as an
Esri Shapefile. If you choose this option, you will need to upload the geojson or ESRI shapefile into the Sandbox using Upload Files button in the top left corner of the Jupyter Notebook interface. ESRI shapefiles must be uploaded with all the related files
(.cpg, .dbf, .shp, .shx). Once uploaded, you can use the shapefile or geojson to define the area of interest. Remember to update the code to call the file you have uploaded.
Pour utiliser l’une de ces méthodes, vous pouvez décommenter la ligne de code concernée et commenter l’autre. Pour commenter une ligne, ajoutez le symbole "#" avant le code que vous souhaitez commenter. Par défaut, la première option qui définit l’emplacement à l’aide de la latitude, de la longitude et du tampon est utilisée.
Si vous exécutez le bloc-notes pour la première fois, conservez les paramètres par défaut ci-dessous. Cela permettra de démontrer le fonctionnement de l’analyse et de fournir des résultats significatifs.
Comme pour le notebook de chargement des données WaPOR <../Datasets/WaPOR.ipynb>, ce notebook de démonstration charge une zone de terres cultivées dans le delta du Nil, en Égypte. Le delta du Nil abrite une agriculture irriguée dans un climat très aride. Cela signifie qu’il présente une couverture nuageuse très faible et des profils de culture facilement identifiables sur l’imagerie satellite, ce qui en fait une zone d’essai utile pour les analyses basées sur l’observation de la Terre.
[4]:
# Method 1: Specify the latitude, longitude, and buffer
aoi = define_area(lat=30.75, lon=31.35, buffer=0.03)

# Method 2: Use a polygon as a GeoJSON or Esri Shapefile.
# aoi = define_area(vector_path='aoi.shp')

#Create a geopolygon and geodataframe of the area of interest
geopolygon = Geometry(aoi["features"][0]["geometry"], crs="epsg:4326")
geopolygon_gdf = gpd.GeoDataFrame(geometry=[geopolygon], crs=geopolygon.crs)

# Get the latitude and longitude range of the geopolygon
lat_range = (geopolygon_gdf.total_bounds[1], geopolygon_gdf.total_bounds[3])
lon_range = (geopolygon_gdf.total_bounds[0], geopolygon_gdf.total_bounds[2])

region = [geopolygon_gdf.total_bounds[0], geopolygon_gdf.total_bounds[1], geopolygon_gdf.total_bounds[2], geopolygon_gdf.total_bounds[3]]

display_map(x=lon_range, y=lat_range)
[4]:
Charger le masque des cultures#
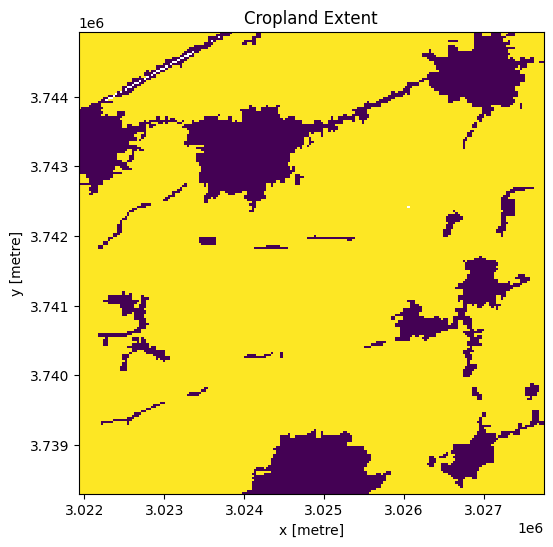
Nous nous intéressons à l’irrigation, nous limitons donc notre analyse aux seules terres cultivées à l’aide de la carte d’étendue des terres cultivées de Digital Earth Africa. Cette carte a été validée comme ayant une bonne précision et une haute résolution pour l’Afrique, parmi d’autres produits d’étendue des terres cultivées. Nous faisons l’hypothèse que toutes les terres cultivées de la zone d’intérêt sont irriguées, ce qui est raisonnablement sûr en Égypte compte tenu de son climat très sec et de sa dépendance à l’irrigation. Dans d’autres régions, d’autres couches de classification des zones irriguées ou de l’utilisation/occupation des sols peuvent être nécessaires pour isoler l’analyse à l’agriculture irriguée.
Tout d’abord, nous chargeons le masque des cultures pour la zone d’intérêt.
[5]:
cm = dc.load(
    product="crop_mask",
    y = (region[1],region[3]),
    x = (region[0],region[2]),
    time=("2019"),
    resolution = (-30,30),
    measurements="filtered",
    resampling="nearest"
).filtered.squeeze()

cm.where(cm < 255).plot.imshow(
    add_colorbar=False, figsize=(6, 6)
)  # we filter to <255 to omit missing data
plt.title("Cropland Extent");
Charger l’ET de référence#
Comme identifié précédemment, l’ETref est la quantité de vapeur d’eau qui serait perdue dans l’atmosphère à partir d’un gazon bien arrosé. Elle représente l’ET qui s’appliquerait à des cultures courtes dans des conditions de croissance idéales et sous des conditions climatiques données.
Nous intégrons les données ETref mondiales de niveau 1 de WaPOR v3 à des pas de temps mensuels. Leur résolution est faible (~30 km) car elles dépendent d’informations climatiques, telles que la température et la vitesse du vent, qui sont généralement disponibles à faible résolution. Pour cette raison, nous prélevons des données sur une zone plus large en ajoutant un degré à la fois à la latitude et à la longitude de notre zone d’intérêt.
[6]:
variable = "L1-RET-M"
period= ["2024-01-01", "2024-12-31"]
region_big = [geopolygon_gdf.total_bounds[0] - 0.5, geopolygon_gdf.total_bounds[1] - 0.5, # create a bigger region due to low resolution of product and abundance of NaNs
              geopolygon_gdf.total_bounds[2] + 0.5, geopolygon_gdf.total_bounds[3] + 0.5]

etref = wapor_map(region_big, variable, period, folder, extension = '.nc')
INFO: Found 12 files for L1-RET-M.
INFO: Converting from `.tif` to `.nc`.
Une fois les données disponibles dans notre dossier Supplementary_data/WaPOR sous forme de NetCDF, nous pouvons les charger dans un objet xarray ci-dessous. Nous filtrons immédiatement les valeurs de données absentes qui sont stockées sous la valeur -999, nous utilisons donc un filtre >0. Nous notons que le scale_factor de 0.1 a été inclus dans la fonction load_wapor_ds() afin que nos données soient en mm/mois.
[7]:
etref_xr = load_wapor_ds(filename=etref, variable=variable)

etref_xr = etref_xr.where(etref_xr['L1-RET-M'] > 0)  # filter out NaNs

etref_xr
[7]:
<xarray.Dataset> Size: 3kB
Dimensions:      (time: 12, y: 6, x: 5)
Coordinates:
  * time         (time) datetime64[ns] 96B 2024-01-01 2024-02-01 ... 2024-12-01
  * y            (y) float64 48B 31.38 31.12 30.88 30.62 30.38 30.12
  * x            (x) float64 40B 30.78 31.09 31.41 31.72 32.03
    spatial_ref  int32 4B 4326
Data variables:
    L1-RET-M     (time, y, x) float64 3kB 74.3 73.5 72.8 73.6 ... nan nan nan
Attributes: (12/13)
    lat#long_name:        latitude
    lat#standard_name:    latitude
    lat#units:            degrees_north
    lon#long_name:        longitude
    lon#standard_name:    longitude
    lon#units:            degrees_east
    ...                   ...
    overview:             NONE
    temporal_resolution:  Month
    units:                mm/month
    scale_factor:         0.1
    _FillValue:           -9999
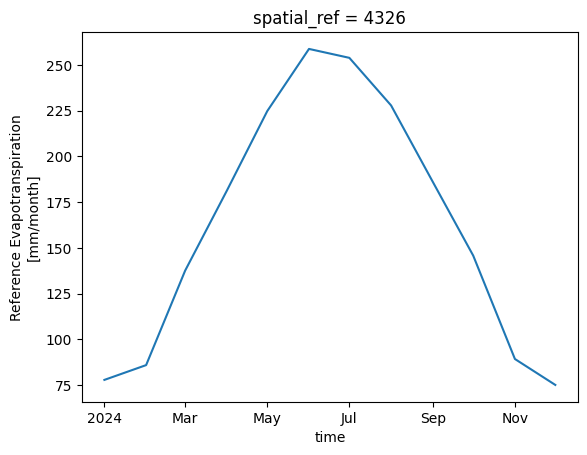
add_offset: 0.0On constate que 12 mois de données sont disponibles. La faible résolution signifie que nous ne sommes pas vraiment intéressés par le modèle spatial de l’ETref, nous examinons donc la série chronologique des valeurs mensuelles d’ETref pour notre zone d’intérêt (en notant que nous avons pris des données d’une zone plus large pour des raisons pratiques).
Nous pouvons voir qu’en 2024, l’ETref était la plus élevée en juin et juillet (été en Égypte) et la plus basse en décembre et janvier (hiver).
[8]:
etref_ts = etref_xr.mean(["x", "y"])

(etref_ts['L1-RET-M']).plot()
[8]:
[<matplotlib.lines.Line2D at 0x7f8839104200>]
Charger l’évapotranspiration réelle#
Ensuite, nous chargeons l’ETact pour la zone d’intérêt. À nouveau, ces données correspondent à l’ET qui s’est réellement produite et sont donc basées sur des observations à plus haute résolution telles que la réflectance de surface et la température, et disponibles dans une résolution spatiale plus élevée (20 m pour les données de niveau 3 WaPOR du nord de l’Égypte que nous allons charger). Nous utiliserons également des pas de temps mensuels (mm/mois) pour l’ETact.
Le même processus est suivi pour charger les données WaPOR, où elles sont d’abord ingérées sous forme de NetCDF puis chargées sous forme d’objet xarray. Les valeurs de données manquantes (stockées sous la valeur -999,9) sont filtrées et le scale_factor est appliqué dans la fonction load_wapor_ds().
[9]:
variable = "L3-AETI-M"
period= ["2024-01-01", "2024-12-31"]

etact = wapor_map(region, variable, period, folder, extension = '.nc')

etact_xr = load_wapor_ds(filename=etact, variable=variable)

etact_xr = etact_xr.where(etact_xr['L3-AETI-M'] > 0) # filter out NaN values
etact_xr
WARNING: `region` intersects with multiple L3 regions (['ENO', 'ZAN']), continuing with ENO only.
INFO: Found 12 files for L3-AETI-M.
INFO: Converting from `.tif` to `.nc`.
[9]:
<xarray.Dataset> Size: 10MB
Dimensions:      (time: 12, y: 338, x: 294)
Coordinates:
  * time         (time) datetime64[ns] 96B 2024-01-01 2024-02-01 ... 2024-12-01
  * y            (y) float64 3kB 3.406e+06 3.406e+06 ... 3.4e+06 3.4e+06
  * x            (x) float64 2kB 3.391e+05 3.392e+05 ... 3.45e+05 3.45e+05
    spatial_ref  int32 4B 32636
Data variables:
    L3-AETI-M    (time, y, x) float64 10MB nan nan nan nan ... nan nan nan nan
Attributes:
    long_name:            Actual EvapoTranspiration and Interception
    overview:             NONE
    temporal_resolution:  Month
    units:                mm/month
    scale_factor:         0.1
    _FillValue:           -9999
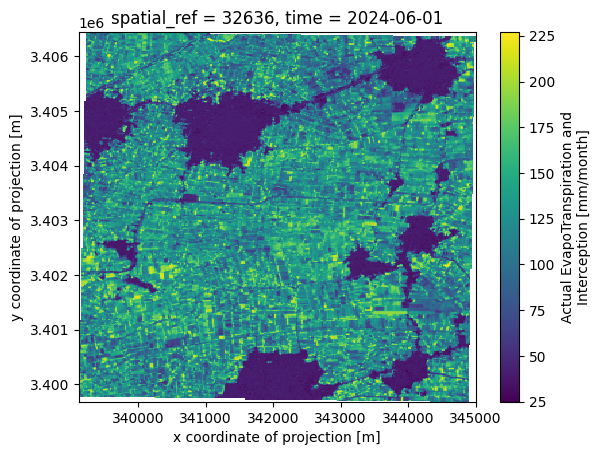
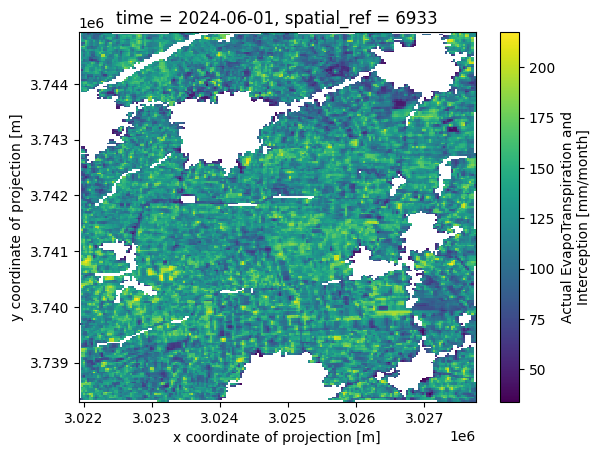
add_offset: 0.0Le produit ETact à plus haute résolution spatiale est agréable à tracer spatialement pour un mois sélectionné (juin ci-dessous).
[10]:
(etact_xr.isel(time=5)['L3-AETI-M']).plot()
[10]:
<matplotlib.collections.QuadMesh at 0x7f8882a1d160>
Masquer l’ETact pour les cultures#
Ensuite, nous devons limiter nos analyses aux terres cultivées et exclure les autres classes de couverture terrestre. Nous faisons cela en reprojetant les données ETact pour correspondre aux données d’étendue des cultures, puis en effectuant une étape de masquage. Le masquage peut être confirmé par un graphique.
[11]:
etact_xr_reprojected = etact_xr.odc.reproject(how=cm.odc.geobox, resampling="average")
etact_xr_reprojected = mask_invalid_data(etact_xr_reprojected)
etact_xr_crop = etact_xr_reprojected.where(cm == 1)

etact_xr_crop.isel(time=5)['L3-AETI-M'].plot()
[11]:
<matplotlib.collections.QuadMesh at 0x7f883158d1c0>
Tracer l’ETact et l’ETref#
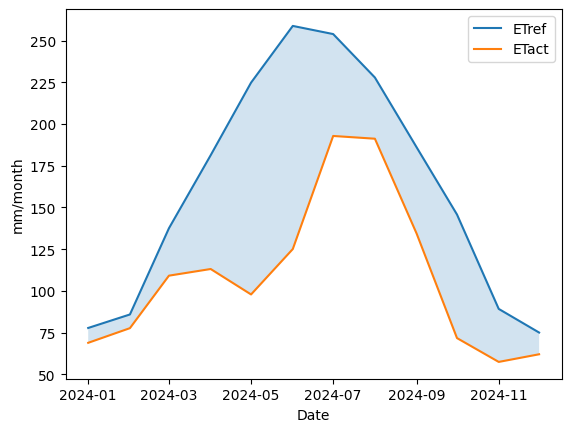
La progression de l’ETact et de l’ETref tout au long de 2024 peut être visualisée ensemble. L’ETref est systématiquement plus élevée, comme prévu, car l’eau du sol et l’état des cultures sont insuffisants pour permettre une ET maximale pour une culture de gazon hypothétique bien irriguée (ETref). La baisse de l’ETact en mai est probablement due à une transition saisonnière entre les cultures.
[12]:
etact_crop_ts = etact_xr_crop.mean(['x', 'y'])

fig, ax = plt.subplots()

ax.plot(etref_ts.time, etref_ts['L1-RET-M'], label="ETref")
ax.plot(etact_crop_ts.time, etact_crop_ts['L3-AETI-M'], label="ETact")
ax.fill_between(etref_ts.time, etact_crop_ts['L3-AETI-M'], etref_ts['L1-RET-M'], alpha=0.2)
ax.set_xlabel('Date')
ax.legend()
ax.set_ylabel('mm/month')
[12]:
Text(0, 0.5, 'mm/month')
Calculer le déficit d’irrigation#
Ensuite, nous pouvons calculer les besoins en eau des cultures pour un mois donné. Pour ce faire, nous devons faire quelques hypothèses sur le type de culture et le stade de croissance. Étant donné que le blé est une culture majeure en Égypte et qu’il est souvent planté pour pousser dans la dernière partie de l’année, nous supposerons que nous avons une culture de blé de mi-saison en août 2024 sur les terres cultivées de notre zone d’intérêt. Bien entendu, cette hypothèse pourrait être adaptée pour différentes périodes et moments d’intérêt.
Cela nous permet d’attribuer un coefficient de culture (Kc) de 1,15 sur la base du Tableau 12 du chapitre de la FAO sur les coefficients de culture. De nombreuses autres sources de valeurs de Kc pourraient être exploitées.
Comme mentionné dans la section Contexte, l’évapotranspiration des cultures (ETc) est l’ET de référence pour une culture spécifique à un stade de croissance donné et est le produit de l’ETref et du Kc. Nous multiplions donc l’ETref par notre valeur de Kc de 1,15 pour obtenir l’ETc pour août 2024. Ensuite, nous pouvons trouver la différence entre l’ETc et l’ETact, qui est effectivement le déficit comme affiché ci-dessous.
[13]:
etc = etref_ts.sel(time='2024-08-01')['L1-RET-M'].values * 1.15

etact = etact_crop_ts.sel(time='2024-08-01')['L3-AETI-M'].values

et_def = etc - etact

print(f"The crop evapotranspiration for mid-season wheat in August 2024 was {round(etc)}mm while the actual evapotranspiration was {round(float(etact))}mm, giving a deficit of {round(et_def)}mm.")
The crop evapotranspiration for mid-season wheat in August 2024 was 262mm while the actual evapotranspiration was 191mm, giving a deficit of 71mm.
Calculer l’utilisation de l’eau par les cultures#
Si nous connaissons la superficie des terres cultivées concernées, nous pouvons estimer l’utilisation totale et les besoins en eau.
Tout d’abord, nous devons estimer la superficie des terres cultivées dans notre zone d’intérêt. La première étape consiste à compter le nombre de pixels classés comme terres cultivées dans le produit d’étendue des terres cultivées. Ensuite, nous multiplions la superficie de chaque pixel par le nombre de pixels. Cela nous donne la superficie des terres cultivées en mètres carrés, que nous pouvons convertir en hectares.
[14]:
res_x, res_y = cm.rio.resolution()
pixel_area = abs(res_x) * abs(res_y)

cm_pixels = cm.where(cm == 1).count().item()
crop_sq_m = pixel_area * cm_pixels
crop_ha = crop_sq_m * 0.0001 # 0.0001 (sq. m to ha)

print(f"Our area of interest has a total cropped area of {crop_ha:.2f} ha.")
Our area of interest has a total cropped area of 3235.59 ha.
Enfin, nous pouvons estimer le volume total de consommation d’eau des cultures irriguées sur la base de 1 mm équivalant à 1 L/m².
[15]:
annual_av_etact = (etact_crop_ts.sum('time')['L3-AETI-M']).values

total_eta_megl = (annual_av_etact * crop_sq_m) / 1e+6 # Actual ET converted to megalitres

print(f"Based on a spatial average annual ETact of {round(float(annual_av_etact))}mm and an area of {crop_ha} ha, {round(total_eta_megl)} megalitres of water was transferred to the atmosphere from cropland for our area of interest in 2024.")
Based on a spatial average annual ETact of 1302mm and an area of 3235.59 ha, 42121 megalitres of water was transferred to the atmosphere from cropland for our area of interest in 2024.
Limites et étapes suivantes#
Ce flux de travail a ignoré les précipitations, qui diminuent les besoins d’irrigation, et le drainage, qui augmente les besoins d’irrigation. Une prochaine étape de l’analyse pourrait consister à intégrer les données mensuelles de précipitations pour calculer la proportion des besoins en eau des cultures satisfaits par les précipitations par rapport à l’irrigation.
Le flux de travail fournit également les premières étapes pour comprendre les besoins en eau de cultures spécifiques et à différents stades de croissance. Les utilisateurs disposant d’informations sur une zone d’intérêt particulière pourront s’appuyer sur ce carnet comme point de départ pour une analyse plus approfondie des performances des cultures irriguées et de la consommation d’eau.
Informations Complémentaires#
Licence : Le code de ce carnet est sous licence Apache, version 2.0 <https://www.apache.org/licenses/LICENSE-2.0>. Les données de Digital Earth Africa sont sous licence Creative Commons par attribution 4.0 <https://creativecommons.org/licenses/by/4.0/>.
Contact : Si vous avez besoin d’aide, veuillez poster une question sur le canal Slack Open Data Cube <http://slack.opendatacube.org/>`__ ou sur le GIS Stack Exchange en utilisant la balise open-data-cube (vous pouvez consulter les questions posées précédemment ici). Si vous souhaitez signaler un problème avec ce bloc-notes, vous pouvez en déposer un sur Github.
Version de Datacube compatible :
[16]:
print(datacube.__version__)
1.8.20
Dernier test :
[17]:
from datetime import datetime
datetime.today().strftime('%Y-%m-%d')
[17]:
'2025-11-25'