Exporter vers Google Drive depuis le Sandbox#
Aperçu#
L’API Google Drive permet aux développeurs d’intégrer les fonctionnalités de Google Drive dans les applications, offrant ainsi un accès aux capacités de stockage, de partage et de synchronisation des fichiers. Elle permet aux utilisateurs de gérer des fichiers, des dossiers et des autorisations par programmation, facilitant l’intégration transparente des fonctionnalités de stockage cloud dans diverses solutions logicielles. L’API prend en charge plusieurs langages de programmation et fournit une documentation solide, ce qui la rend polyvalente pour une large gamme d’applications, de la gestion de documents aux plateformes collaboratives. Plus d’informations sont disponibles ici.
PyDrive2 est une bibliothèque d’encapsulation de google-api-python-client qui simplifie de nombreuses tâches courantes de l’API Google Drive V2. La fonction deafrica_tools.externaldrive.authenticate utilise les fonctionnalités de la bibliothèque PyDrive2 pour authentifier et autoriser les requêtes API, permettant ainsi d’intégrer de manière transparente les fonctionnalités de Google Drive directement dans les flux de travail de la science des données, sans intervention de l’utilisateur.
Pour vous connecter à l’API Google Drive depuis le bac à sable (sandbox), suivez les instructions ici pour :
Activer l’API Google Drive
Configurer l’écran de consentement OAuth
Autoriser les identifiants pour une application de bureau
À la fin des instructions de l’étape 3, Autoriser les identifiants pour une application de bureau, il vous sera demandé d’enregistrer le fichier JSON téléchargé sous le nom credentials.json. Une fois cette étape terminée, chargez le fichier credentials.json dans le dossier /home/jovyan/Supplementary_data/DriveCredentials.
Si vous souhaitez utiliser un autre dossier pour stocker votre fichier JSON d’identifiants et votre fichier JSON de jeton d’accès utilisateur, une fois que vous avez chargé le credentials.json dans le dossier souhaité, transmettez le chemin absolu du dossier à la variable gdrive_credentials_dir.
⚠️ Considérations de sécurité : Les utilisateurs doivent veiller à assurer la sécurité des identifiants importés dans le Sandbox. Cela implique de s’assurer qu’ils ne sont pas inclus par inadvertance dans des publications vers des dépôts publics comme GitHub.
Description#
Ce carnet fournit une brève introduction à l’accès et à l’utilisation du bac à sable de Digital Earth Africa avec Google Drive :
1 - Autoriser et authentifier les identifiants Google Drive
2 - Interagir avec Google Drive à l’aide du système de fichiers fsspec
Créer un répertoire
Téléverser des fichiers
Lire des fichiers
Supprimer des fichiers
Écrire des fichiers
Télécharger des fichiers
Commencer#
Charger des paquets#
Importez les packages Python utilisés pour l’analyse.
[1]:
import os

import datacube
import matplotlib.pyplot as plt
import odc.algo
import rasterio
import rioxarray
from deafrica_tools.bandindices import calculate_indices
from deafrica_tools.externaldrive import authenticate
from deafrica_tools.plotting import rgb
from odc.geo.xr import write_cog
from pydrive2.fs import GDriveFileSystem
Autoriser et authentifier les identifiants Google Drive#
Dans cette section, nous utiliserons la fonction authenticate pour gérer le processus d’autorisation et d’authentification pour Google Drive à l’aide de PyDrive2. La fonction s’assure que les identifiants de l’API Google Drive (credentials.json) sont correctement chargés, gère le jeton d’accès (token.json) et renvoie un objet GoogleAuth que nous utiliserons pour interagir avec Google Drive (téléverser, télécharger ou gérer des fichiers).
Définissez le dossier dans lequel se trouve le fichier credentials.json.
[2]:
gdrive_credentials_dir = "/home/jovyan/Supplementary_data/DriveCredentials"
Si vous exécutez la cellule ci-dessous pour la première fois, une URL s’affichera dans la sortie de la cellule et vous serez invité à saisir un code d’autorisation/vérification. Pour obtenir ce code, suivez les étapes suivantes :
Copiez le lien de l’URL et ouvrez-le dans votre navigateur.
Il vous sera demandé de choisir un compte. Cliquez sur le compte Google pour lequel vous avez téléchargé le fichier JSON
credentials.json.Dans les deux écrans suivants, cliquez sur Continuer jusqu’à ce que vous arriviez à une page contenant une section Code d’autorisation.
Copiez le code, saisissez-le dans le champ de saisie et appuyez sur Entrée.
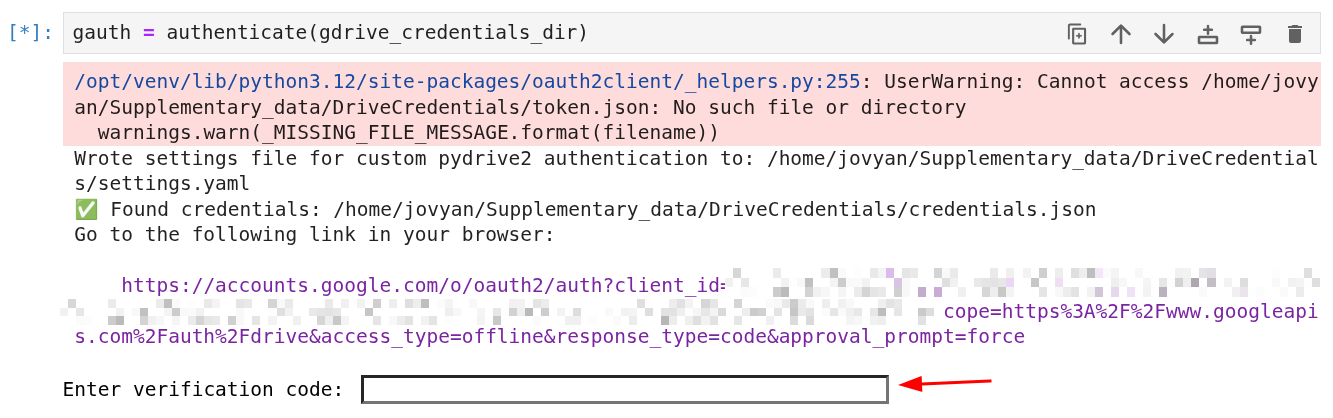
Une fois que vous aurez terminé l’étape 5, la cellule s’exécutera et vous verrez le message « Authentication successful. » s’afficher dans la sortie de la cellule.
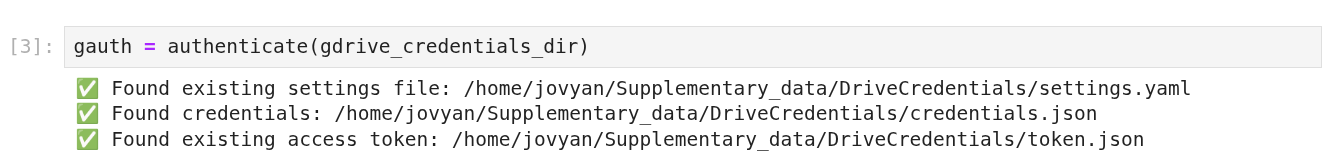
Si vous avez déjà exécuté la cellule de code ci-dessous auparavant et qu’un jeton d’accès utilisateur (« token.json ») a été généré, vous verrez les messages suivants s’afficher dans la sortie de la cellule.
[3]:
gauth = authenticate(gdrive_credentials_dir)
✅ Found existing settings file: /home/jovyan/Supplementary_data/DriveCredentials/settings.yaml
✅ Found credentials: /home/jovyan/Supplementary_data/DriveCredentials/credentials.json
✅ Found existing access token: /home/jovyan/Supplementary_data/DriveCredentials/token.json
⚠️ Vous devez réautoriser vos identifiants Google Drive à chaque fois que vous vous connectez (redémarrage de votre instance de bac à sable), car le stockage du bac à sable est réinitialisé après chaque session.
Interagir avec Google Drive à l’aide du système de fichiers fsspec#
PyDrive2 fournit un moyen simple de travailler avec vos fichiers via le `GDriveFileSystem <https://docs.iterative.ai/PyDrive2/pydrive2/#pydrive2.fs.GDriveFileSystem>`__ compatible avec `fsspec <https://filesystem-spec.readthedocs.io/en/latest/>`__. Une instance de système de fichiers fsspec offre un grand nombre de méthodes pour obtenir des informations sur les fichiers et les manipuler, reportez-vous aux documents fsspec sur comment utiliser un système de fichiers.
Cette section du carnet vous guidera à travers le téléchargement, le chargement ou la gestion des fichiers à l’aide des fonctionnalités fsspec.
Création d’un répertoire#
Dans cette section, nous allons créer un dossier dans votre Google Drive pour stocker les sorties de ce carnet. Tous les chemins de dossiers et de fichiers doivent être absolus et commencer par le répertoire root. Les chemins ne commençant pas par root peuvent être considérés comme invalides. root fait référence au répertoire de niveau supérieur dans Google Drive, appelé « Mon Drive », qui sert de hiérarchie principale pour tous les fichiers et dossiers de l’utilisateur. Ce dossier racine est le point de départ de l’organisation du contenu dans Google Drive, et tous les autres dossiers et fichiers en découlent.
Instanciez une instance de système de fichiers compatible fsspec à l’aide de GDriveFileSystem et de l’objet GoogleAuth que nous avons créé dans la section Autoriser et authentifier les identifiants Google Drive.
[4]:
# "root" is the root folder of your Google Drive
fs = GDriveFileSystem("root", google_auth = gauth)
Créez un dossier dans votre Google Drive.
ℹ️ Info : Tous les chemins de dossiers et de fichiers doivent être absolus et commencer par le répertoire root. Les chemins ne commençant pas par root peuvent être considérés comme invalides.
[5]:
folder_path = "root/basic_analysis"
[6]:
fs.mkdir(folder_path)
Téléverser des fichiers#
Dans cette section, nous allons téléverser un fichier du bac à sable vers le dossier créé dans la section précédente.
Définissez le chemin absolu du fichier sur Google Drive.
[7]:
file_path = "root/basic_analysis/test_gdrive.txt"
Créez le fichier texte à téléverser en écrivant les éléments d’une liste dans un fichier texte.
[8]:
data_list = [
    "First item to write.",
    "Second item to write.",
    "Third item to write."
]
with open("test_local.txt", 'w') as f:
    for item in data_list:
        f.write(item + '\n')
Téléversez le fichier sur Google Drive.
[9]:
fs.upload("test_local.txt", file_path)
Vérifiez que le fichier a été téléversé en listant les éléments du dossier.
[10]:
fs.ls("root")
[10]:
['root/Colab Notebooks/', 'root/NEMAUseCase/', 'root/basic_analysis/']
[11]:
fs.ls("root/basic_analysis/")
[11]:
['root/basic_analysis/test_gdrive.txt']
Lire les fichiers#
Dans cette section, nous lirons le fichier texte que nous avons téléversé sur Google Drive dans la section précédente.
[12]:
file_path = "root/basic_analysis/test_gdrive.txt"
[13]:
# Read files from drive
with fs.open(file_path, "r") as f:
    lines = f.readlines()

# Remove newline characters
lines = [line.strip() for line in lines]

print(lines)
['First item to write.', 'Second item to write.', 'Third item to write.']
Supprimer des fichiers#
Dans cette section, nous supprimerons le fichier texte que nous avons téléversé sur Google Drive dans la section précédente.
[14]:
file_path = "root/basic_analysis/test_gdrive.txt"
[15]:
fs.rm(file_path)
Vérifiez que le fichier a été supprimé en listant les éléments du dossier.
[16]:
fs.ls("root/basic_analysis/")
[16]:
[]
Écrire des fichiers#
Dans cette section, nous allons écrire un fichier directement sur Google Drive. Cela peut être un moyen plus efficace d’enregistrer des fichiers sur votre Google Drive plutôt que de devoir les écrire localement d’abord puis de les téléverser sur Google Drive en étapes distinctes.
Cette section revisitera des parties du flux de travail démontré dans le carnet Performing a basic analysis notebook.
Définir les paramètres d’analyse.
[17]:
# Connect to the datacube
dc = datacube.Datacube(app="Basic_analysis")

# Select a study area and a buffer
# Set the central latitude and longitude
central_lat = -31.5393
central_lon = 18.2682

# Set the buffer to load around the central coordinates
buffer = 0.03

# Compute the bounding box for the study area
study_area_lat = (central_lat - buffer, central_lat + buffer)
study_area_lon = (central_lon - buffer, central_lon + buffer)
Charger les données Sentinel-2 pour la zone d’intérêt.
[18]:
# Set the data source - s2a corresponds to Sentinel-2A
set_product = "s2_l2a"

# Set the date range to load data over
set_time = ("2018-01-01", "2018-01-15")

# Set the measurements/bands to load
# For this analysis, we'll load the red, green, blue and near-infrared bands
set_measurements = [
    "red",
    "blue",
    "green",
    "nir"
]

# Set the coordinate reference system and output resolution
set_crs = 'EPSG:6933'
set_resolution = (-10, 10)
[19]:
dataset = dc.load(
    product=set_product,
    x=study_area_lon,
    y=study_area_lat,
    time=set_time,
    measurements=set_measurements,
    output_crs=set_crs,
    resolution=set_resolution,
    group_by='solar_day'
)
dataset
[19]:
<xarray.Dataset> Size: 9MB
Dimensions:      (time: 3, y: 655, x: 580)
Coordinates:
  * time         (time) datetime64[ns] 24B 2018-01-04T08:57:02 ... 2018-01-14...
  * y            (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
  * x            (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
    spatial_ref  int32 4B 6933
Data variables:
    red          (time, y, x) uint16 2MB 2502 2600 2754 2754 ... 1826 953 1238
    blue         (time, y, x) uint16 2MB 955 949 1015 1011 ... 1094 918 552 780
    green        (time, y, x) uint16 2MB 1580 1630 1718 1700 ... 1310 827 1005
    nir          (time, y, x) uint16 2MB 3200 3366 3442 3504 ... 2946 2420 1908
Attributes:
    crs:           EPSG:6933
grid_mapping: spatial_refSélectionner le pas de temps à utiliser dans le flux de travail.
[20]:
dataset = dataset.isel(time=0)
dataset
[20]:
<xarray.Dataset> Size: 3MB
Dimensions:      (y: 655, x: 580)
Coordinates:
  * y            (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
  * x            (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
    time         datetime64[ns] 8B 2018-01-04T08:57:02
    spatial_ref  int32 4B 6933
Data variables:
    red          (y, x) uint16 760kB 2502 2600 2754 2754 ... 1788 1462 993 1208
    blue         (y, x) uint16 760kB 955 949 1015 1011 954 ... 1007 771 495 820
    green        (y, x) uint16 760kB 1580 1630 1718 1700 ... 1380 1094 805 1001
    nir          (y, x) uint16 760kB 3200 3366 3442 3504 ... 2692 2976 2542 2024
Attributes:
    crs:           EPSG:6933
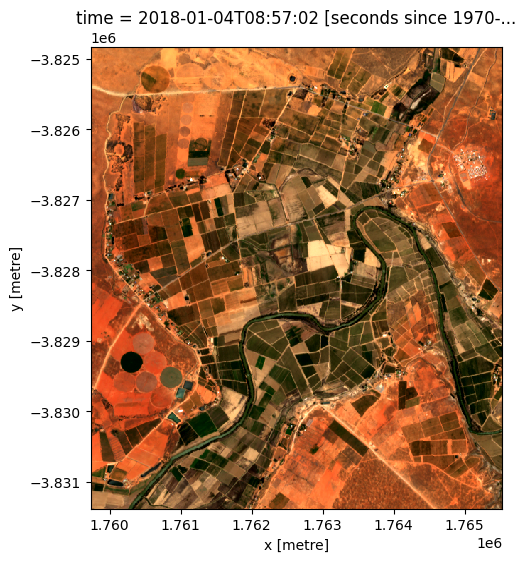
grid_mapping: spatial_refUtilisez la fonction rgb() pour tracer le pas de temps sélectionné. La fonction rgb() mappe trois variables/mesures de données du jeu de données chargé vers les canaux rouge, vert et bleu qui sont utilisés pour créer une image tricolore.
[21]:
rgb(dataset)
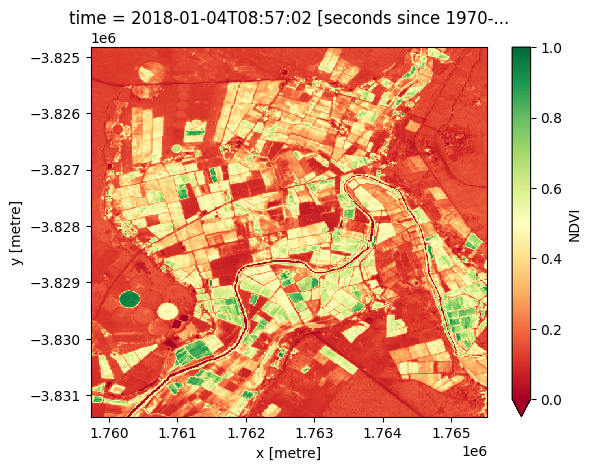
Calculer la santé de la végétation à partir des données sélectionnées.
[22]:
# Convert dataset to float32 datatype so no-data values are set to NaN
dataset =  odc.algo.to_f32(dataset)
# Calcule NDVI
ndvi = calculate_indices(dataset, index="NDVI", satellite_mission="s2", drop=True)
ndvi
Dropping bands ['red', 'blue', 'green', 'nir']
[22]:
<xarray.Dataset> Size: 2MB
Dimensions:      (y: 655, x: 580)
Coordinates:
  * y            (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
  * x            (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
    time         datetime64[ns] 8B 2018-01-04T08:57:02
    spatial_ref  int32 4B 6933
Data variables:
    NDVI         (y, x) float32 2MB 0.1224 0.1284 0.111 ... 0.3411 0.4382 0.2525
Attributes:
    crs:           EPSG:6933
grid_mapping: spatial_ref[23]:
# Plot the NDVI band
ndvi["NDVI"].plot(cmap="RdYlGn", vmin=0, vmax=1)
plt.show()
Exporter la bande NDVI vers un fichier COG dans votre Google Drive à l’aide de la commande write_cog() de la bibliothèque odc-geo et fsspec.
[24]:
cog_file_path = "root/basic_analysis/ndvi.geotiff"
Écrivez d’abord le xarray.DataArray dans un fichier COG en mémoire.
[25]:
da = ndvi.NDVI
da
[25]:
<xarray.DataArray 'NDVI' (y: 655, x: 580)> Size: 2MB
array([[0.12241318, 0.12839426, 0.11103933, ..., 0.12687685, 0.1313949 ,
        0.12835819],
       [0.12829289, 0.1247136 , 0.10674693, ..., 0.12770721, 0.13333334,
        0.13129775],
       [0.12309822, 0.12321488, 0.11476469, ..., 0.13343924, 0.13364053,
        0.13167256],
       ...,
       [0.09936731, 0.1018315 , 0.09043151, ..., 0.35731646, 0.369863  ,
        0.13691507],
       [0.15498447, 0.14464428, 0.12185836, ..., 0.3640167 , 0.4338498 ,
        0.19569121],
       [0.17833877, 0.16302522, 0.14487337, ..., 0.34114465, 0.43818957,
        0.25247523]], shape=(655, 580), dtype=float32)
Coordinates:
* y (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
* x (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
time datetime64[ns] 8B 2018-01-04T08:57:02
spatial_ref int32 4B 6933[26]:
cog_bytes = write_cog(
                    geo_im=ndvi.NDVI,
                    fname=":mem:",
                    overwrite=True,
                )
Écrivez le fichier en mémoire sur votre Google Drive à l’aide de fsspec.
[27]:
with fs.open(cog_file_path, "wb") as f:
    f.write(cog_bytes)
Vérifiez que le fichier a été téléversé en listant les éléments du dossier.
[28]:
fs.ls("root/basic_analysis/")
[28]:
['root/basic_analysis/ndvi.geotiff']
Vous pouvez lire le fichier GeoTIFF que vous avez téléversé directement dans un xarray.DataArray, en gardant à l’esprit les contraintes soulignées ci-dessous.
⚠️ Avertissement : L’objet fichier renvoyé par fsspec pour Google Drive est en streaming uniquement. Il ne prend pas en charge l’accès aléatoire requis par rasterio afin de lire les en-têtes, les bandes et les décalages dans un COG. La méthode démontrée ci-dessous lira tous les octets en mémoire. Pour les fichiers très volumineux, cela peut planter ou ralentir votre système.
[29]:
# read all bytes from GDrive
data = fs.open(cog_file_path, "rb").read()
with rasterio.io.MemoryFile(data) as memfile:
    ndvi_from_gdrive = rioxarray.open_rasterio(memfile)

ndvi_from_gdrive
[29]:
<xarray.DataArray (band: 1, y: 655, x: 580)> Size: 2MB
[379900 values with dtype=float32]
Coordinates:
  * band         (band) int64 8B 1
  * y            (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
  * x            (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
    spatial_ref  int64 8B 0
Attributes:
    AREA_OR_POINT:  Area
    _FillValue:     nan
    scale_factor:   1.0
add_offset: 0.0Télécharger des fichiers#
Une alternative à la lecture directe des fichiers depuis Drive consiste à télécharger d’abord le fichier, puis à lire le fichier téléchargé. Cela peut être particulièrement utile pour les fichiers trop volumineux pour la mémoire.
Spécifiez le chemin d’accès pour télécharger le fichier. Cela peut être relatif à ce carnet ou un chemin de fichier absolu.
[30]:
download_path = "ndvi_downloaded.tiff"
Spécifiez le chemin du fichier à télécharger depuis Google Drive.
[31]:
gdrive_file_path = "root/basic_analysis/ndvi.geotiff"
Utilisez fsspec pour télécharger le fichier.
[32]:
fs.get(gdrive_file_path, download_path)
Vérifiez si le fichier a été téléchargé.
[33]:
if os.path.exists(download_path):
    print("File was successfully downloaded")
File was successfully downloaded
[34]:
# Read the downloaded geotiff file.
ndvi_ = rioxarray.open_rasterio(download_path)
ndvi_
[34]:
<xarray.DataArray (band: 1, y: 655, x: 580)> Size: 2MB
[379900 values with dtype=float32]
Coordinates:
  * band         (band) int64 8B 1
  * y            (y) float64 5kB -3.825e+06 -3.825e+06 ... -3.831e+06 -3.831e+06
  * x            (x) float64 5kB 1.76e+06 1.76e+06 ... 1.766e+06 1.766e+06
    spatial_ref  int64 8B 0
Attributes:
    AREA_OR_POINT:  Area
    _FillValue:     nan
    scale_factor:   1.0
add_offset: 0.0Informations Complémentaires#
Licence : Le code de ce carnet est sous licence Apache, version 2.0 <https://www.apache.org/licenses/LICENSE-2.0>. Les données de Digital Earth Africa sont sous licence Creative Commons par attribution 4.0 <https://creativecommons.org/licenses/by/4.0/>.
Contact : Si vous avez besoin d’aide, veuillez poser une question sur le canal Slack de Digital Earth Africa ou sur le GIS Stack Exchange en utilisant le tag open-data-cube (vous pouvez consulter les questions précédemment posées ici). Si vous souhaitez signaler un problème avec ce carnet, vous pouvez le faire sur Github.
Version de Datacube compatible :
[35]:
import datacube
print(datacube.__version__)
1.8.20
Dernier test :
[36]:
from datetime import datetime
datetime.today().strftime('%Y-%m-%d')
[36]:
'2025-12-08'